
Fast alle Unternehmen wünschen sich KI aus Deutschland, in der Praxis dominieren aber internationale Tools. Fünf konkrete Prüfpunkte zeigen, wie du Datensouveränität bei der KI-Auswahl bewertest.
93 Prozent der Unternehmen in Deutschland würden am liebsten auf KI aus Deutschland setzen, das zeigt die Bitkom-Studie zu KI in Deutschland. Für 88 Prozent ist das Herkunftsland des Anbieters ein wichtiges Kriterium. Im Arbeitsalltag sieht es anders aus: 70 Prozent der Unternehmen mit generativer KI nutzen ChatGPT, europäische Anbieter wie Aleph Alpha (0,3 Prozent) oder Mistral (0,2 Prozent) spielen kaum eine Rolle.
Daraus folgt kein Urteil gegen ChatGPT, Copilot oder Gemini. Wer KI beruflich nutzt, sollte aber wissen, wohin die eigenen Daten fließen. Genau das meint Datensouveränität: selbst zu kontrollieren, wo Daten verarbeitet werden, wer darauf zugreifen kann und von welchen Anbietern ein Unternehmen technisch abhängig ist.
Mit dieser Frage arbeiten wir bei DialogBits täglich. DialogBits ist die in Deutschland entwickelte Plattform der Web Computing GmbH für KI-Assistenten und KI-Agenten. In Kundenprojekten fragen Unternehmen meist zuerst nach dem Sprachmodell. Über die Datensouveränität entscheidet aber die gesamte Architektur: wo das Modell läuft, welche Plattform die Daten verarbeitet und wer den Betrieb verantwortet.
Datensouveränität ist mehr als DSGVO
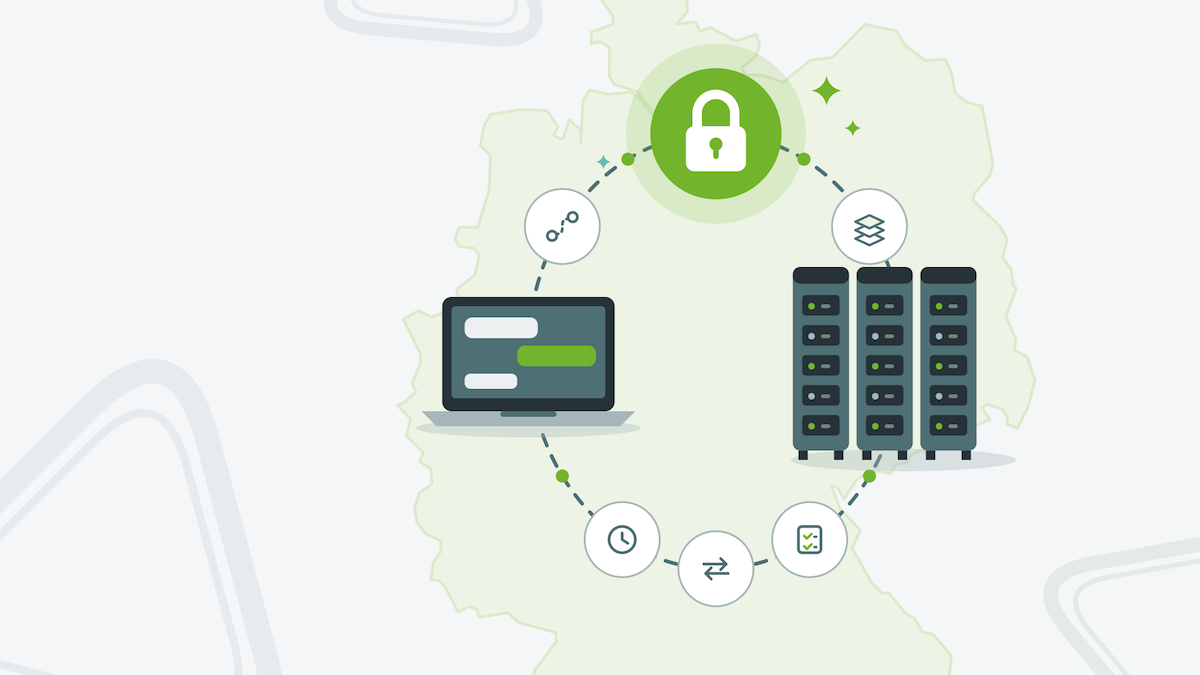
Beim Thema KI und Datenschutz wird schnell nur auf den Serverstandort geschaut. Das greift zu kurz. Eine KI-Lösung besteht vereinfacht aus drei Bausteinen: Sprachmodell, Plattform und Hosting. Datensouveränität entsteht nur, wenn diese drei Ebenen zusammenpassen.
Auch eine DSGVO-konforme KI ist deshalb nicht automatisch souverän. Der US-amerikanische CLOUD Act kann US-Anbieter verpflichten, Daten an US-Behörden herauszugeben, auch wenn sie außerhalb der USA gespeichert sind. Neben dem Speicherort zählt also auch, wo der Anbieter sitzt und wer technisch oder rechtlich Zugriff haben kann.
Dass das Thema Unternehmen beschäftigt, zeigen weitere Bitkom-Zahlen: 48 Prozent sehen Datenschutzanforderungen als Hemmnis beim KI-Einsatz, 39 Prozent sorgen sich, dass Unternehmensdaten in falsche Hände geraten. Bei DSGVO-Verstößen drohen Bußgelder von bis zu 20 Millionen Euro oder 4 Prozent des weltweiten Jahresumsatzes, je nachdem, welcher Betrag höher ist. Die Architektur einer KI-Lösung sollte deshalb vor dem Rollout geklärt sein, nicht danach.
5 Tipps für eine souveränere KI-Auswahl
- Frage nach dem kompletten Datenweg. Wo werden Eingaben verarbeitet und gespeichert, wie lange bleiben sie erhalten und wer kann darauf zugreifen? Wer beim Thema ChatGPT und Datenschutz nur auf den Anbieter schaut, übersieht den eigentlichen Punkt: Welche Daten fließen in deinem Anwendungsfall tatsächlich in das Tool?
- Prüfe Modell, Plattform und Hosting getrennt. Ein datenschutzfreundliches Frontend reicht nicht, wenn unklar bleibt, was im Modell oder in der Infrastruktur passiert. Gute Anbieter können diese drei Ebenen nachvollziehbar erklären.
- Kläre Training und Speicherdauer vorab. Lass dir schriftlich beantworten, ob Prompts oder hochgeladene Inhalte für das Training verwendet werden und welche Löschfristen gelten. Wie DSGVO-konforme KI aus Deutschland mit technisch aufgebaut sein kann, zeigt dieses Beispiel und hilft bei der eigenen Prüfliste.
- Achte auf Modellunabhängigkeit. Wenn sich ein Sprachmodell austauschen lässt, sinkt das Risiko eines Vendor-Lock-ins. Das schafft Spielraum, wenn sich Kosten, Anforderungen oder regulatorische Rahmenbedingungen ändern.
- Verhindere Schatten-KI mit klaren Regeln. Nur 23 Prozent der Unternehmen haben feste Regeln für generative KI. In 8 Prozent der Unternehmen nutzen Beschäftigte KI-Tools bereits in großem Stil außerhalb der offiziellen Angebote. Das zeigt eine Bitkom-Umfrage. Definiere deshalb freigegebene Tools, zulässige Daten und Zuständigkeiten. Seit Februar 2025 verpflichtet der EU AI Act Unternehmen außerdem, für ausreichende KI-Kompetenz ihrer Beschäftigten zu sorgen.
Wie digitale Souveränität in der Praxis aussehen kann
Ein Beispiel ist der S-KIPilot, der KI-Assistent der Sparkassen-Finanzgruppe. Er basiert auf der DialogBits-Plattform der Web Computing GmbH, die heute zur Finanz-Informatik-Gruppe gehört. Seit Juli 2024 ist der Assistent im Einsatz, inzwischen in über 300 Sparkassen. Rund 200.000 Mitarbeitende haben Zugang, pro Monat werden mehr als 4 Millionen fachliche Prompts verarbeitet.
Der Betrieb läuft in der Infrastruktur der Finanz Informatik. Datenverarbeitung und zentrale Sicherheitsmechanismen bleiben damit in eigener Hand. Gleichzeitig ist die Plattform modellunabhängig: Je nach Anforderung lassen sich unterschiedliche Sprachmodelle einbinden. Für uns bei DialogBits gehören dazu drei Grundsätze: eine DSGVO-konforme Architektur, die Option auf On-Premise-Betrieb und Entwicklung in Deutschland.
Ein Herkunftslabel allein garantiert also noch keine KI made in Germany. Souverän wird eine Lösung erst, wenn sich nachprüfen lässt, wer Daten, Infrastruktur und Modellwahl kontrolliert. So sieht digitale Souveränität in der Praxis aus.
Datensouveränität ist kein Bremsklotz
Auch die Beschäftigten selbst sind verunsichert: 63 Prozent der Erwerbstätigen nennen es als Nachteil von KI am Arbeitsplatz, dass unklar sei, an wen ihre Daten gehen. Das ergab eine Bitkom-Umfrage.
Wer diese Frage sauber beantwortet, verbessert die Compliance und gewinnt das Vertrauen der Menschen, die mit den Tools arbeiten sollen.
Deutsche KI muss dafür nicht jedes Sprachmodell selbst entwickeln. Es reicht, die Kontrolle über Daten und Infrastruktur zu behalten und das Modell wechseln zu können, wenn sich Anforderungen ändern. Datensouveränität ist damit vor allem eines: Handlungsfreiheit.
Über den Autor: Markus Zeggel verantwortet als Head of AI die KI-Strategie bei DialogBits. Er hat den S-KIPilot, den KI-Assistenten der Sparkassen-Finanzgruppe, mitentwickelt und beschäftigt sich mit praxisnaher KI-Implementierung in regulierten Branchen.
Quellen
Bitkom-Presseinformation „Beschäftigte nutzen vermehrt Schatten-KI“, 21.10.2025.
Methodik: 604 Unternehmen ab 20 Beschäftigten, telefonisch, KW 27–32/2025, repräsentativ (Bitkom Research).
Belegt: 23 % haben Regeln für den Einsatz generativer KI aufgestellt (2024: 15 %). 8 %: private KI-Nutzung durch Beschäftigte ist „weit verbreitet“ (2024: 4 %) – „in großem Stil“ ist unsere Umschreibung.
Bitkom-Umfrage „KI-Einsatz bei der Arbeit: Beschäftigte sind geteilter Meinung“, 04.04.2024.
Methodik: 1.004 Personen ab 16 Jahren, davon 511 Erwerbstätige, telefonisch, KW 41–44/2023.
Korrektur: Laut Quelle sind es 63 %, nicht 66 %. Die 66 % gehören zu „Menschen verlassen sich zu sehr auf KI“.
Hinweis: Die Daten stammen aus Ende 2023 und sind damit die ältesten im Artikel.